

















一文搞懂AI大模型收錄原理與關鍵技巧
被AI大模型優先推薦的關鍵不是堆量,而是把資訊做到:結構化、場景化、權威化。核心流程:先理解模型偏好 → 劃分使用者意圖 → 寫場景化結構化內容 → 多管道穩定投放 → 監測迭代與維護,下面大兵來分享一下國內主要AI大模型(豆包/元寶/Deepseek)收錄原理與關鍵技巧。
不同AI大模型的收錄偏好(重點對比:豆包/元寶/Deepseek)
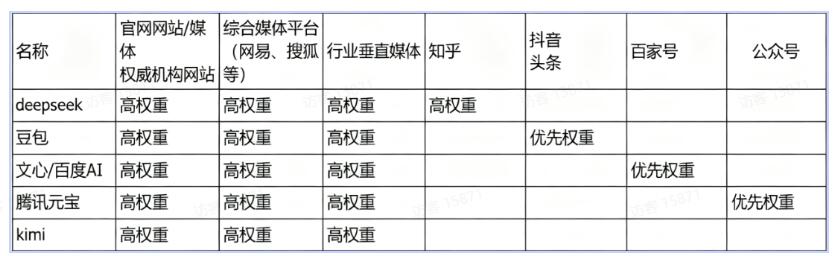
1、豆包的偏好與打法
偏好:結構性強、答案前置、引用權威(報告/專家);
來源傾向:字節系與有媒體報導/學術支撐的內容優先;
優化要點:開頭150-200字給出直接結論;內文用表格/列表;引用檢測、報告提升可信度;
實例:把產品主打點做成「問題—結論—關鍵數據」格式,豆包更易把你做為首要答案。
2、元寶的偏好與打法
偏好:微信生態內容(公眾號、影片號、騰訊新聞)與入口網站(中華網、金山網等)深度長文;
來源傾向:騰訊系更新穩定、互動良好的帳號具有天然優勢;
優化要點:在騰訊系做系列深度內容並同步影片號短片,提高生態內信任鏈路。同時關注各大入口網站。
3、Deepseek的偏好與打法
偏好:產業知識圖譜、實體關係清晰的結構化內容;
來源傾向:官網、行業站、結構化 FAQ 頁面的權重顯著;
優化要點:構建「品牌—產品—功能—案例—證書」的實體鏈,並在頁面使用清單/表格/FAQ。
4、其他模型簡要備註
文心:偏百度系資源(百度百科、百家號);
Kimi:來源廣泛,引用知乎、新聞、技術社群;
實操建議:不要把雞蛋放同一個籃子,多管道覆蓋以應對各模型偏好差異。
人工智慧大潮已來,不學習就有可能被淘汰,如果你是技術人,尤其是網際網路從業者,現在就開始學習AI大模型技術,還不遲。